视频大模型三方反馈范式上线,面向真实直播建模持续决策 - 搜狐网
High confidence: full text extraction produced 4575 characters.
视频大模型三方反馈范式上线,面向真实直播建模持续决策
Live Assistant团队 投稿
量子位 | 公众号QbitAI
直播大模型,最难的可能不是“看见了什么”,而是知道什么时候该闭嘴,什么时候该记住,以及该把话说给谁。
在真实直播间里,模型面对的是一个持续变化、信号异构、反馈对象多元的现场。可现有的视频大模型,大多还停留在“边看边解说”或“你问我答”的阶段,默认了一个隐含前提:模型的任务就是不停地说。
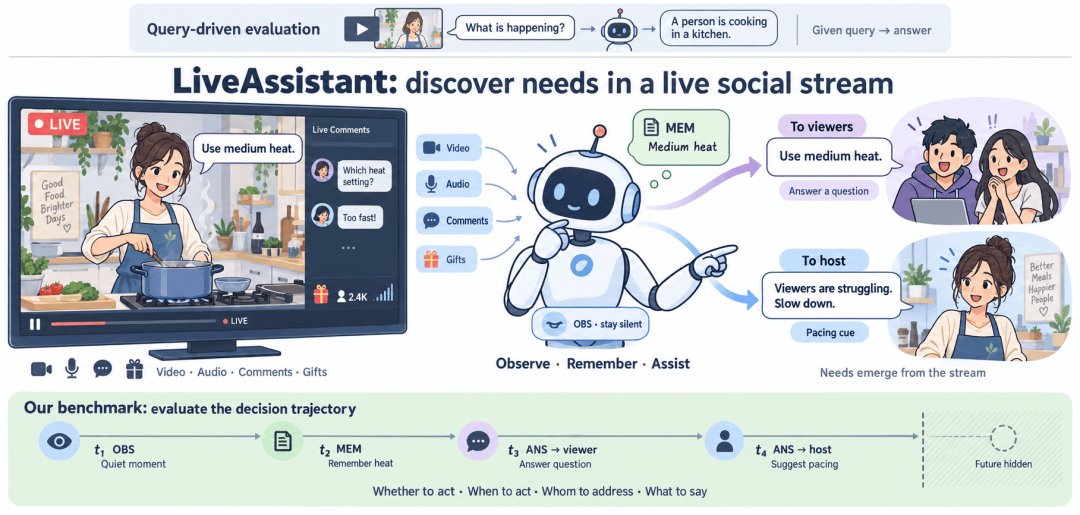
针对这一现状,复旦大学可信具身智能研究院、Bytedance International Live Content AI团队与上海创智学院联合发布Live Assistant,面向真实直播场景提出了一套基于内容理解的三方反馈范式。
该不该说、说给谁、说什么类型——这三个问题,构成了Live Assistant的全部行动语法。
现有视频大模型,卡在了哪儿
过去的视频理解模型大多处理两类问题:一种是离线长视频问答,模型先看完整视频,再回答用户问题;另一种是在线逐片段解说,模型按时间片生成实时描述。
近两年也出现了一批直播/在线视频理解工作:有的强调用户query驱动的在线问答,有的把视频流切成连续片段做实时解说,有的重点优化长视频记忆,让模型在更长时间范围内保留上下文。
这些方向解决了“模型如何边看边理解视频”的问题,但距离真实直播间仍有三道坎:
第一,直播被简化成了“视频帧+文本”。很多live理解工作仍把直播当作“图像帧+文本问题”,或者把音频先转成ASR文本再输入模型。可真实直播里的主播语气、背景音、弹幕密度、礼物事件、在线人数变化、房间meta信息和平台规则,并不是附属信息,而是会共同改变模型判断的原生信号。
第二,反馈对象太单一。现有系统要么回答用户问题,要么给观众生成解说。但直播助手真正服务的是多方:观众需要解释和recap,主播需要评论区问题、节奏变化和关键事件提醒,平台/审核侧需要风险线索和待复核片段。
第三,“不说话”没有被当成一个动作。很多在线模型仍由用户问题或固定时间片驱动,到了一个片段就输出一段话。但在真实直播里,“沉默”本身就是一个重要且合法的动作。模型必须基于内容理解判断:当前是继续观察,还是写入记忆,还是在关键事件、高光、评论爆发、节奏异常或安全风险出现时主动反馈。
这也引出了Live Assistant的核心问题定义:真实直播本质上是一个异构、长时、多方互动、混合驱动的多模态信号流。Live Assistant要建模的不是单次回答,而是直播过程中的持续状态决策。
六层设计:从多模态信号到长程行动策略
Live Assistant的技术设计可以拆成六层:Omni原生多模态直播信号、内容理解驱动状态机与多方反馈、多轮SFT、多轮RL、长程推理框架,以及贯穿数据、SFT、RL的训推一致性设计。
下面这张图先给出整体的“决策骨架”——直播信号进来后,模型如何一步步走到“该不该说、说给谁、说什么”:
△=沉默也是合法输出;=记住,而不是重复说;=说,但要说给对的人、说对的类型。虚线表示状态会回流到下一片段的内容理解,构成持续的状态决策循环。Omni原生多模态直播信号
区别于一些只使用视觉帧和文本query、或先把音频转成ASR文本再送入模型的方案,团队基于Omni原生多模态底座,直接建模视频、音频、文本以及直播间外部信号。
这样做的意义在于,直播里的很多关键状态并不只存在于画面里:主播语气变化、背景音、弹幕密度、礼物事件、实时人数波动,都可能共同决定模型是否应该输出。
换句话说,Live Assistant不是把直播简化成“长视频+文字问题”,而是把真实直播看作一个持续到来的多模态信号流。
内容理解驱动状态机×多方反馈
团队将每个直播片段的输出压缩成三个核心动作:
- :当前继续观察,不打扰直播节奏。
- ... :把后续可能有用的线索写入记忆。
- [task]... :面向观众或主播输出具体反馈;安全和审核相关任务可通过task标签进入平台侧工作流。
其中task可以覆盖narration、key event、highlight moment、viewer QA、entity pinning、pacing alert、newcomer recap、FAQ gap、safety alert等直播任务。这个状态机让模型不再只是“生成一段描述”,而是在学习直播助手的行动策略。
它对应真实直播里的三个问题:该不该说、说给谁、说什么类型。
而多方反馈不是简单的后处理路由,而是状态机的一部分。比如同样是“评论区大量询问尺码”,对观众侧可能是FAQ回答,对主播侧可能是提醒主播补充说明;同样是“直播节奏突然冷场”,对观众侧不一定需要输出,但对主播侧可能需要pacing alert。
多轮SFT:让模型先学会直播行为语法
在SFT阶段,团队采用多轮直播SFT:一个训练样本包含多个连续直播片段,模型在前后文中学习每一轮应该观察、记忆还是开口。
为了让模型更敏感地学会关键决策,团队对“状态、对象、任务”三类标记引入额外的候选标记损失。也就是说,除了普通语言模型loss,训练还会显式强化
这一步解决的是直播助手最基础、却最容易被忽略的问题:模型不能只学会“说得像”,还要学会什么时候不说、什么时候先记、什么时候对正确的人说。
同时,SFT只监督助手输出位置,用户输入、媒体内容和外部信号只作为上下文。这让模型学习的是直播行动本身,而不是复读输入内容。
多轮RL:优化直播行动策略
仅靠SFT可以学到格式和常见行为,但直播里的关键问题往往是策略问题:什么时候该说,什么时候不该说,说给谁,说成什么类型。
因此,团队进一步构建了多轮RL训练链路,从SFT模型继续优化。训练过程中,模型按直播片段连续采样动作,再根据整条直播轨迹的收益进行更新。
RL reward直接围绕直播状态机定义:模型必须输出一个合法状态,非法格式直接惩罚;如果是
更关键的是,多轮直播不是单turn任务。团队同时建模turn-level credit和trajectory-level credit:当前轮的输出承担当前动作的责任,而一整条直播轨迹的收益会影响长程策略。这样模型学到的不是“每轮都多说一点”,而是“在长期直播效果最好的时间点,说对的话”。
这使得Live Assistant的训练目标更接近真实使用方式:模型不是为了每秒都说一句话,而是为了在长时间直播中做出少而准、可解释、对多方有用的反馈。
面向长时直播的长程推理框架
真实直播往往持续几十分钟甚至数小时。如果每轮都把完整历史重放给模型,成本和延迟都会迅速失控。
因此,团队把推理侧定位成一个长程流式推理框架:模型按片段增量读取新的视频、音频、文本和直播信号,同时保留一套可持续更新的历史记忆,用于跨事件、跨问答、跨直播节奏变化的推理。
技术上,团队把历史分成两级:近期窗口保留高密度原始上下文,更早历史进入压缩记忆。这样模型不需要每轮重放完整直播历史,也能保留跨片段推理所需的关键线索。
更重要的是,记忆按直播轮次对齐,而不是随意切开视频、音频和文本。直播中的一个事件往往由画面、声音和弹幕共同构成;如果三种模态在历史裁剪时被打散,模型看到的就不再是同一个事件。按轮次对齐的记忆,正是为了减少这种语义错位。
训推一致性:从数据标注到在线采样链路
流式直播训练最容易出现的问题是训推不一致:训练时模型看到完整拼接上下文,推理时却只能看到增量片段和被保留下来的历史记忆;训练时像普通长文本,推理时像一个持续行动的助手。
- 数据标注阶段,不把不同片段当成相互独立的短视频。团队会把前一个片段的边界状态、历史记忆和关键外部信号传给下一个片段,让标注模型感知直播状态的连续变化。这样生成的监督信号不是“每段单独描述”,而是一条逐步演化的状态序列。
- SFT阶段,样本以多轮因果语言建模形式组织:前序用户/助手轮次作为后续轮次的上下文,只有助手输出位置参与训练loss。历史内容会被展开成记忆轮次,再进入当前片段的多轮交互;额外标记损失继续强化状态、对象、任务三类关键决策标记。
- RL阶段,在线采样链路和最终推理链路保持一致,而不是另写一套离线生成逻辑。模型同样按直播片段增量推进,同样使用长程记忆,同样在每一轮输出/ / 状态。
当前稳定基线中,采样结果只用于优化当前轮动作,下一轮历史先使用标注状态,避免RL初期因为错误历史快速漂移;后续可逐步过渡到混合历史和模型自生成历史,进一步逼近真实在线推理。
一个基模能力之外的新任务
结果展示:
团队定义了一个直播流视频理解场景下的新任务,这个任务是base model的参数分布之外的,所以未经过训练的base模型甚至无法做到指令跟随,如表格所示,指标均为0。团队的递进式训练策略,包含多轮sft和多轮rl,都实现了稳定有效的提升。
case展示:
不是更会说,而是更知道何时说
Live Assistant的价值,不在于把某个视频benchmark的分数又刷高了几个点,而在于它把视频大模型真正推进到了真实直播场景——一个持续、异构、多方在场的现场。
它服务的从来不是一个人,而是一整个直播现场里的所有角色:
- 对观众,它可以做实时讲解、背景补全、新人recap和高光提示;
- 对主播,它可以提醒评论区问题、节奏变化、商品/游戏关键节点和观众反馈;
- 对审核人员,它可以在长时直播中标注潜在风险、异常事件和需要复核的片段。
更重要的是,这套范式把直播理解从“被动回答”推进到了“内容驱动的主动协同”。模型既能看见多模态现场,也能理解弹幕、礼物、人数这些外部信号,还能判断——此刻是否应该打断当前直播节奏,以及这句话到底该说给谁听。
这背后其实是一个更大的判断:AI与人、与真实世界的交互潜力,远没有被发掘完。当模型不再只是“回答提问”,而是开始主动决定“向谁、在何时、发出哪一类反馈”时,它才真正从一个“会看视频的模型”,变成一个“能参与现场协作的助手”。
而这,可能正是直播大模型走向真实生产系统时必须补上的一环:不是更会说,而是更知道何时该说、该对谁说。
论文、开源与合作团队
作者团队简介:本项目由复旦大学可信具身智能研究院、Bytedance International Live Content AI团队与上海创智学院联合完成。学校负责人为吴祖煊、姜育刚老师;团队负责人为周鹏豪、王庆磊。这个工作也得到了杨雨辰、严佳媚的支持。
项目面向真实Bytedance直播场景,使用真实直播数据,探索真实世界直播理解、记忆与反馈建模。
论文链接:https://arxiv.org/abs/2609.27303
GitHub:https://github.com/Daryl-GSJ/LiveAssistant
HuggingFace:https://huggingface.co/collections/Yah-daryl/live-assistant
项目页/博客:https://daryl-gsj.github.io/LiveAssistant/